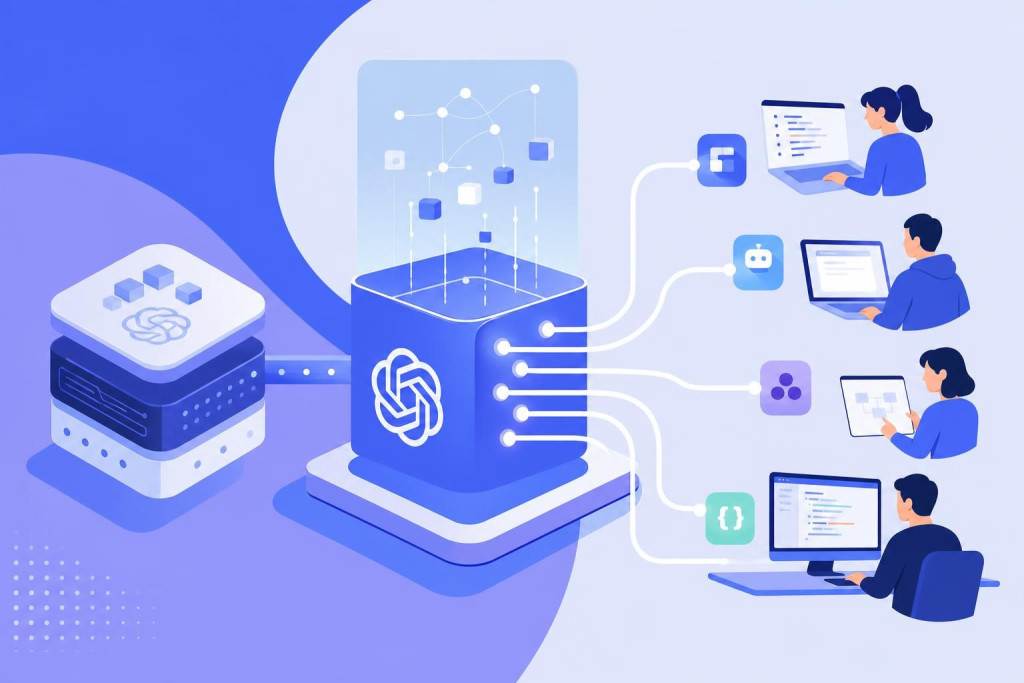
OpenAI a lancé, le 11 septembre 2026, une bêta publique de son API Agents, une infrastructure conçue pour permettre aux développeurs de créer et d’exécuter des agents autonomes dans le cloud. En ouvrant les composants techniques employés derrière Codex, l’entreprise ne propose pas seulement un nouveau point d’accès à ses modèles : elle cherche à industrialiser l’usage de l’API Agents d’OpenAI pour automatiser des tâches complexes, de la programmation à la recherche documentaire, avec des implications directes pour les éditeurs de logiciels, les équipes marketing et les entreprises qui structurent leur production de contenus.
L’annonce intervient dans une phase de concurrence accrue entre les grands fournisseurs de modèles d’intelligence artificielle. Après les assistants conversationnels et les API de génération de texte, la bataille se concentre désormais sur les agents : des systèmes capables d’enchaîner des instructions, de sélectionner des outils, de conserver un contexte de travail et de produire un résultat sans intervention humaine à chaque étape.
Une API Agents d’OpenAI conçue à partir du socle technique de Codex
Le passage d’un produit interne à une infrastructure commerciale
Codex, l’outil d’OpenAI destiné notamment aux tâches de développement logiciel, reposait jusqu’ici sur une infrastructure spécifique : environnement d’exécution distant, gestion des outils, mémoire de contexte, orchestration des appels au modèle et mécanismes de contrôle. Avec l’API Agents, OpenAI rend cette architecture accessible aux développeurs sous la forme d’un service cloud.
Le principe annoncé est volontairement simple : un appel API doit permettre de créer un agent en précisant sa mission, le modèle mobilisé, les outils autorisés et son environnement d’exécution. Cette approche vise à réduire le travail d’intégration habituellement nécessaire pour bâtir un système agentique fiable.
Dans les entreprises, l’enjeu ne porte pas seulement sur la qualité d’une réponse générée. Il concerne la capacité à faire exécuter une séquence de travail complète : consulter une base de données, analyser un document, comparer des sources, rédiger une synthèse, appliquer des règles métier puis transmettre un livrable à un outil tiers.
Le « harnais » d’agent, une couche souvent sous-estimée
OpenAI présente son offre comme l’ouverture du « harnais » utilisé par Codex. Dans le vocabulaire technique, ce terme désigne la couche qui encadre un modèle de langage afin qu’il puisse opérer dans un environnement donné. Le modèle ne suffit pas à lui seul : il faut définir les droits d’accès, gérer les erreurs, limiter les boucles de raisonnement, sélectionner les outils pertinents et mémoriser les éléments utiles à la tâche.
Cette couche opérationnelle est devenue un point de différenciation majeur. Les entreprises qui développent leurs propres agents doivent généralement assembler plusieurs briques : modèle de langage, système de mémoire, connecteurs, environnement de calcul, supervision humaine et journalisation. L’API Agents promet de centraliser une partie de cette architecture.

« Un seul appel API suffit pour créer un agent », résume OpenAI dans la présentation relayée le 11 septembre 2026. La promesse vise à déplacer la complexité technique depuis les équipes clientes vers l’infrastructure de l’éditeur.
Des fonctions pensées pour les workflows longs et multi-outils
La gestion du contexte, un enjeu de coût et de fiabilité
L’une des fonctions mises en avant est le compactage automatique du contexte. Les agents opérant sur des tâches longues accumulent des messages, des résultats d’outils et des documents intermédiaires. Sans mécanisme de synthèse ou de hiérarchisation, cette accumulation augmente rapidement le volume de tokens traités, alourdit la facture et peut dégrader la pertinence des décisions prises par le modèle.
Le compactage consiste à résumer ou réorganiser les informations issues des étapes précédentes pour préserver les éléments utiles au traitement suivant. Pour des scénarios de veille, d’audit de site, de qualification de prospects ou de production éditoriale, cette fonction peut être déterminante : un agent doit pouvoir maintenir le fil d’une mission sans transporter l’intégralité de son historique à chaque appel.
Recherche d’outils et appels parallèles
L’API Agents comprend également des mécanismes de recherche d’outils optimisée et d’exécution parallèle. Dans une architecture agentique, l’agent peut devoir choisir entre de nombreux connecteurs : moteur de recherche, tableur, CRM, système de publication, base documentaire ou environnement de code. La sélection du bon outil, au bon moment, conditionne la vitesse comme la qualité du résultat.
Les appels parallèles répondent à une autre limite : une suite d’opérations strictement séquentielle peut ralentir fortement les traitements. Une analyse de contenu peut, par exemple, exiger de vérifier simultanément des données de marché, la structure d’une page, des sources documentaires et des signaux de concurrence. L’exécution en parallèle réduit potentiellement le temps total, à condition que les résultats soient ensuite consolidés de manière cohérente.
- Création d’agents cloud depuis une requête API unique ;
- Paramétrage de la tâche, du modèle, des outils et de l’environnement d’exécution ;
- Compactage automatisé du contexte de travail ;
- Sélection d’outils optimisée ;
- Prise en charge de scénarios multi-agents ;
- Exécution de certains appels en parallèle.
Le multi-agent, une réponse à la spécialisation des tâches
Le support multi-agent ouvre la voie à une répartition des rôles. Un premier agent peut rechercher des sources, un deuxième évaluer leur fiabilité, un troisième rédiger une synthèse et un quatrième vérifier le respect d’un format ou d’une charte. Ce modèle reproduit, sous une forme automatisée, la division du travail déjà employée dans les organisations.
Cette logique reste toutefois dépendante de règles précises. Un ensemble d’agents mal configuré peut multiplier les coûts, créer des contradictions entre sorties ou automatiser des erreurs à grande échelle. La multiplication des agents ne constitue donc pas, en elle-même, une garantie de productivité.
| Date / Indicateur | Événement / Valeur |
|---|---|
| 11 septembre 2026 | Ouverture en bêta publique de l’API Agents d’OpenAI |
| Infrastructure d’origine | Composants et harnais technique employés derrière Codex |
| Création d’un agent | Définition de la tâche, du modèle, des outils et de l’environnement d’exécution |
| Facturation annoncée | Tokens et outils effectivement consommés, sans surcoût propre à l’API |
| Fonctions mises en avant | Compactage du contexte, appels parallèles, recherche d’outils et multi-agent |
Une tarification qui déplace l’attention vers la consommation réelle
Pas de surcoût d’API annoncé
Selon les informations publiées lors du lancement, OpenAI indique ne pas appliquer de surcoût spécifique pour l’usage de l’API Agents. La facturation repose sur les tokens consommés par les modèles et sur les outils utilisés. Cette présentation peut faciliter l’adoption par les équipes qui cherchent à éviter une superposition d’abonnements ou de licences.
Le coût réel d’un agent ne se limite pourtant pas au prix affiché d’une requête. Il dépend du nombre d’étapes nécessaires, de la taille du contexte traité, des appels externes, de la fréquence d’exécution et des éventuelles reprises après erreur. Un agent qui vérifie cinq sources, exploite plusieurs documents et sollicite plusieurs sous-agents peut coûter sensiblement plus qu’une génération de texte isolée.
La question du retour sur investissement
Pour les entreprises, l’évaluation doit donc porter sur le processus remplacé ou accéléré. Dans la production éditoriale, la valeur n’est pas seulement liée au nombre d’articles produits. Elle dépend de la capacité à identifier les sujets prioritaires, respecter les intentions de recherche, actualiser les contenus existants, contrôler les sources et publier avec régularité.
Les plateformes spécialisées dans l’automatisation du contenu, telles que Syntezio, se situent précisément sur cette couche métier : génération de cocons sémantiques, rédaction optimisée selon les critères E-E-A-T, veille RSS, refonte des pages existantes et publication sur WordPress. Une API agentique peut renforcer ces chaînes de production, mais elle ne remplace pas la définition d’une stratégie SEO, l’arbitrage éditorial ou la validation des informations sensibles.
Quels usages pour le marketing, le SEO et l’édition de contenu ?
Automatiser la veille sans abandonner le contrôle éditorial
Les agents sont particulièrement adaptés aux opérations répétitives à forte intensité documentaire. Une équipe marketing peut leur demander de surveiller des flux RSS, de repérer des annonces de concurrents, de classer des sujets par potentiel de trafic ou de préparer une première note de synthèse.
Dans ce cadre, l’automatisation réduit le temps consacré à la collecte et au tri. La publication, elle, requiert toujours une gouvernance : contrôle de l’exactitude, distinction entre fait et interprétation, vérification des droits sur les données utilisées et cohérence avec le positionnement de la marque.
De la recherche de mots-clés au cocon sémantique
Un agent peut aussi relier plusieurs opérations habituellement séparées : extraction de requêtes, regroupement par intention, analyse des pages déjà présentes sur un site, identification des contenus manquants et proposition de maillage interne. Cette chaîne correspond au principe du cocon sémantique, qui vise à organiser les contenus autour de thématiques et d’intentions de recherche complémentaires.
Pour être utile, cette automatisation doit s’appuyer sur des données fiables et des contraintes clairement définies. L’agent doit notamment savoir distinguer un sujet stratégique d’une requête périphérique, éviter la cannibalisation entre pages et intégrer les priorités commerciales de l’entreprise.
La publication WordPress comme dernier maillon automatisable
L’exécution automatisée peut aller jusqu’à la mise en ligne dans un CMS. Cette possibilité transforme la nature du travail : il ne s’agit plus d’utiliser l’IA comme un simple outil de rédaction, mais de configurer une chaîne éditoriale où recherche, production, contrôle et publication sont reliés.
Le risque est alors celui d’une publication massive sans supervision. Les moteurs de recherche ne sanctionnent pas mécaniquement l’usage de l’IA ; ils évaluent avant tout l’utilité, la fiabilité et l’originalité des pages. Google rappelle dans ses recommandations sur les contenus utiles que les contenus doivent répondre aux besoins des internautes, quelle que soit la méthode employée pour les produire.
Les limites : sécurité, responsabilité et hallucinations
Un agent dispose d’une capacité d’action
Un assistant conversationnel produit principalement du texte. Un agent peut consulter des données, déclencher un outil, modifier un fichier, lancer du code ou publier un contenu. Cette capacité d’action accroît l’intérêt économique du dispositif, mais elle augmente aussi les risques opérationnels.
Dans un environnement professionnel, la gestion des permissions devient centrale. Un agent chargé d’alimenter un site WordPress ne devrait pas disposer des mêmes accès qu’un agent limité à l’analyse de tendances. De même, l’accès à un CRM, à une base clients ou à des documents internes impose des règles de sécurité, des journaux d’activité et une procédure de validation humaine.
Le problème persistant de la vérification factuelle
Les grands modèles de langage peuvent produire des informations inexactes tout en conservant une formulation convaincante. Les systèmes agentiques ne font pas disparaître cette limite. Ils peuvent même l’amplifier lorsqu’une décision erronée est transmise automatiquement d’un outil à un autre.
La mise en place d’un contrôle humain est particulièrement nécessaire dans plusieurs cas :
- publication d’informations réglementaires, financières ou médicales ;
- diffusion de données chiffrées susceptibles d’influencer une décision commerciale ;
- modification de contenus déjà positionnés sur les moteurs de recherche ;
- accès à des données personnelles ou confidentielles ;
- actions irréversibles dans un CMS, un outil publicitaire ou un système de relation client.
Les exigences européennes de traçabilité
Les entreprises européennes devront également intégrer les obligations graduelles prévues par le règlement européen sur l’intelligence artificielle. Le texte, adopté en 2024, prévoit une application progressive de ses dispositions selon les catégories de risques. Les systèmes agentiques utilisés dans des processus sensibles devront faire l’objet d’une attention particulière en matière de documentation, de supervision et de gestion des risques.
Le cadre juridique peut être consulté sur le portail de la Commission européenne consacré au règlement sur l’IA. Pour les acteurs du contenu, l’enjeu est moins de freiner l’automatisation que de prouver la maîtrise des données, des sources et des décisions prises par les outils.
Une concurrence qui se joue désormais sur l’orchestration
Les modèles ne sont plus l’unique facteur de différenciation
Le marché de l’IA générative a longtemps été structuré par les performances des modèles : compréhension, raisonnement, qualité d’écriture, génération de code ou vitesse de réponse. L’émergence des agents modifie la comparaison. Les entreprises regardent désormais la capacité des plateformes à connecter des outils, protéger les accès, réduire les coûts de contexte et intégrer l’IA dans les logiciels existants.
Cette évolution place l’orchestration au centre de la compétition. Un modèle performant mais isolé peut suffire pour rédiger un brouillon. Il devient moins adapté lorsqu’il faut exécuter un processus complet, avec des règles de sécurité, des données propriétaires et une série d’actions automatisées.
OpenAI cherche à devenir une couche d’infrastructure
Avec l’API Agents, OpenAI étend sa position au-delà de la fourniture de modèles. L’entreprise ambitionne de fournir l’environnement où les agents sont créés, exécutés et facturés. Cette stratégie rappelle celle des fournisseurs de cloud, qui cherchent à capter non seulement l’usage d’un logiciel, mais aussi l’infrastructure indispensable à son fonctionnement.
Le choix d’une bêta publique laisse toutefois ouvertes plusieurs questions : maturité des mécanismes de sécurité, stabilité des coûts à grande échelle, capacité de personnalisation et compatibilité avec les outils métiers déjà utilisés par les entreprises.
Vers des chaînes de production éditoriale plus autonomes
Le contenu devient un processus piloté, plutôt qu’une tâche isolée
Pour les directions marketing, l’intérêt des agents tient à leur capacité à relier des opérations aujourd’hui dispersées. La veille alimente l’idéation, l’idéation nourrit le calendrier éditorial, le calendrier guide la rédaction, puis la mise à jour et la publication. L’automatisation de bout en bout peut améliorer la régularité et réduire les délais de production.
La mesure de performance reste l’arbitre. Une automatisation pertinente doit être suivie par des indicateurs concrets : évolution du trafic organique, taux de conversion, part des contenus mis à jour, délai entre détection d’un sujet et publication, positionnement des pages stratégiques et coût de production par contenu qualifié.
La valeur se déplacera vers la configuration et le contrôle
L’accès simplifié aux agents pourrait banaliser une partie de la production de contenu. La différenciation se jouera alors dans la qualité des données fournies, la précision des règles éditoriales, l’architecture SEO, la capacité à produire une expertise identifiable et l’organisation du contrôle humain.
OpenAI met ainsi à disposition une infrastructure susceptible d’accélérer le déploiement d’agents spécialisés. Reste à savoir quelles entreprises sauront transformer cette capacité technique en processus rentables, contrôlables et réellement utiles. À mesure que les agents passeront de l’expérimentation à la production, la question ne sera plus seulement celle de ce qu’ils peuvent générer, mais de ce qu’ils sont autorisés à faire.