

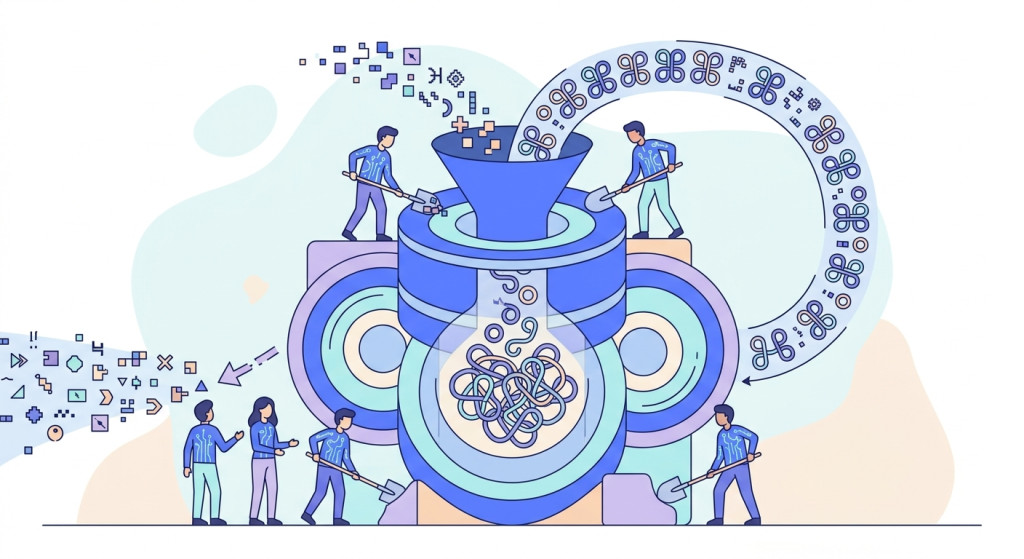
Alors que la production d’informations générées automatiquement atteint des volumes inédits à l’automne 2026, la cannibalisation des données par l’intelligence artificielle menace le fondement même de l’écosystème numérique. Selon des notes confidentielles circulant au sein de Microsoft et d’OpenAI, le tarissement du trafic Web vers les éditeurs traditionnels étouffe la création de contenus rédigés par des humains. Cette boucle de rétroaction négative priverait à terme les grands modèles de langage des informations fraîches et fiables indispensables à leur mise à jour régulière.
La cannibalisation des données par l’intelligence artificielle et l’impasse du web synthétique
Un constat partagé en interne chez les géants de la tech
Les rapports confidentiels récents émanant des principaux concepteurs de grands modèles de langage traduisent une inquiétude croissante. Les algorithmes de recherche générative, en apportant des réponses directes aux utilisateurs, réduisent drastiquement la circulation vers les sites d’information. En privant la presse et les créateurs indépendants de revenus publicitaires et d’abonnements, ces systèmes détruisent la ressource même qui a permis leur apprentissage initial. Les chercheurs qualifient ce phénomène de boucle d’auto-destruction éditoriale.
En pratique, l’abondance de contenus générés à bas coût commence à contaminer le Web ouvert. Les robots d’exploration collectent désormais des fragments de données rédigés par d’autres algorithmes, créant un phénomène de consanguinité cognitive.
La crise d’attractivité et de viabilité pour la presse en ligne
Du côté des éditeurs de presse, la chute des audiences en provenance des moteurs de recherche modifie en profondeur l’équilibre financier. Les données mesurées au cours du troisième trimestre 2026 montrent une baisse moyenne de 25 % à 40 % du trafic référentiel pour les grands portails d’actualité. Cette érosion brutale réduit la rentabilité des rédactions traditionnelles et contraint certains médias à réduire le nombre de journalistes sur le terrain.
Cependant, sans présence humaine pour vérifier les faits, analyser les contextes politiques ou réaliser des enquêtes empiriques, le stock global de connaissances factuelles stagne.
Le phénomène du « model collapse » ou la dégradation progressive des algorithmes
L’endogamie algorithmique face à l’épreuve des faits
Les travaux universitaires publiés dans la revue Nature démontrent que le réentraînement récursif d’un modèle sur des données générées par une intelligence artificielle entraîne inévitablement un « model collapse ». Cette dégradation structurelle se caractérise par une perte d’amplitude dans les réponses, l’apparition d’hallucinations récurrentes et une uniformisation du style rédactionnel.
L’entraînement d’un modèle d’intelligence artificielle sur du contenu synthétique non filtré revient à faire des copies de copies. Au bout de quelques générations, le signal d’origine s’efface au profit d’un bruit statistique incohérent.
Cette observation scientifique pose un problème concret aux ingénieurs en apprentissage automatique. La rareté des textes d’origine humaine non contaminés devient le principal goulot d’étranglement pour le développement des futures architectures d’apprentissage.
Une perte irréversible de diversité et d’ancrage dans le réel
En complément de la dégradation des performances logiques, l’effondrement des modèles touche la diversité culturelle et linguistique. Les nuances dialectales, les figures de style complexes et les analyses marginales s’effacent au profit des tournures les plus fréquentes et prévisibles. Les modèles finissent par l’intermédiaire de statistiques agrégées par lisser l’information jusqu’à la rendre stérile.
Parallèlement, la capacité des outils à appréhender des événements d’actualité immédiats s’amoindrit lorsque le vivier de sources primaires s’amenuise.
| Étape du cycle | Impact sur l’écosystème éditorial | Concurrence et qualité des données |
|---|---|---|
| Phase 1 : Indexation massive | Aspiration des contenus humains qualifiés | Excellente précision des modèles de base |
| Phase 2 : Réponses synthétiques | Chute du trafic sortant vers les éditeurs (-30%) | Émergence de sites automatisés à faible valeur |
| Phase 3 : Re-moulinage synthétique | Fermeture ou réduction de rédactions humaines | Apparition du « model collapse » et perte de précision |
| Phase 4 : Pénurie de données fraîches | Dépendance accrue aux bases de données fermées | Revalorisation stratégique du contenu expert certifié |
Les répercussions économiques sur le modèle des médias et de l’édition
La baisse drastique du trafic référent depuis les moteurs de recherche
L’intégration de modules de synthèse directement au sommet des résultats de recherche modifie le comportement des internautes. Le parcours utilisateur s’arrête de plus en plus fréquemment sur la page de résultats, sans visite sur le site source. Ce constat frappe particulièrement les articles d’information pratique, les guides d’achat et les synthèses encyclopédiques.
Cette mutation oblige les responsables marketing et les directions éditoriales à réévaluer la rentabilité de leur production. La quête du volume brut au profit du référencement traditionnel ne suffit plus à garantir la pérennité économique d’un média.
L’adoption forcée de l’automatisation par les groupes éditoriaux
Face à la contraction de leurs marges, plusieurs groupes de presse majeurs, à l’image de Prisma Media ou de régies numériques internationales, ont entrepris de rationaliser leurs coûts en déployant des chaînes de création automatisées. Cette stratégie vise à maintenir un volume de publication élevé pour capturer les requêtes restantes tout en réduisant la masse salariale.
En pratique, cette réaction crée un cercle vicieux. En remplaçant la rédaction humaine par des textes générés automatiquement, les éditeurs alimentent à leur tour la masse de données synthétiques qui dégrade la qualité globale du Web.
Les stratégies d’urgence pour préserver le réservoir de connaissances humaines
Les accords commerciaux d’exclusivité avec les éditeurs historiques
Afin de sécuriser leur approvisionnement en données fraîches et vérifiées, les firmes de la Silicon Valley multiplient les contrats de licence payants. Des acteurs comme OpenAI ou Google signent des partenariats pluriannuels chiffrés en dizaines de millions d’euros avec des organismes de presse internationaux et des banques de données académiques.
Ces accords permettent aux laboratoires d’intelligence artificielle de bénéficier d’un flux continu de textes structurés, protégés par le droit d’auteur et exempts de pollution synthétique.
Le développement de méthodes d’entraînement sur données synthétiques qualifiées
Du côté de la recherche industrielle, les équipes d’ingénieurs tentent de développer des protocoles de filtrage rigoureux. L’objectif est de produire des données synthétiques « propres », contrôlées par des algorithmes de vérification logique et formelle avant d’être réinjectées dans la phase d’apprentissage.
Cependant, les experts s’accordent à dire que cette méthode présente des limites pour les sciences humaines, l’analyse politique et la création littéraire, où l’expérience humaine directe reste irremplaçable.
Les perspectives pour la création de contenu et le référencement naturel
La valeur renouvelée des critères E-E-A-T et de l’expertise humaine
Face à la prolifération de textes générés mécaniquement, les moteurs de recherche durcissent leurs critères d’évaluation de la qualité. L’expérience, l’expertise, l’autorité et la confiance (E-E-A-T) deviennent les paramètres fondamentaux pour distinguer la valeur réelle d’une page Web.
- Vérification sur le terrain : Priorité accordée aux contenus démontrant des preuves de tests réels, des reportages directs ou des citations originales.
- Analyse d’experts certifiés : Valorisation des auteurs identifiés disposant d’un historique académique ou professionnel vérifiable.
- Transparence méthodologique : Obligation d’afficher les méthodes de collecte d’informations et l’utilisation éventuelle d’outils d’assistance informatique.
Cette évolution technique redéfinit le paysage de l’optimisation pour les moteurs de recherche. La quantité céda la place à la pertinence et à l’originalité stricte de l’information proposée.
Vers un équilibre vertueux entre automatisation et souveraineté éditoriale
La viabilité à long terme de la création numérique repose désormais sur un modèle hybride. L’utilisation de plates-formes SaaS spécialisées permet aux entreprises de gérer les tâches répétitives, la structuration sémantique et la veille d’actualité via des flux RSS ou des outils de pilotage automatisé. Cette rationalisation offre un gain de temps précieux aux équipes stratégiques.
En déléguant l’architecture de contenu et l’organisation technique, les responsables marketing réinvestissent leurs ressources dans la valeur ajoutée humaine : l’enquête, la prise de position engagée et la recherche de retour sur investissement concret pour leurs campagnes SEO.
La suraccumulation de données générées par des machines contraint ainsi l’industrie numérique à une clarification salutaire. Si l’intelligence artificielle est un outil d’exécution puissant pour structurer et diffuser l’information, la création de valeur primaire demeure l’apanage de la réflexion humaine, sous peine de voir l’ensemble du réseau s’enfermer dans un écho algorithmique stérile.


