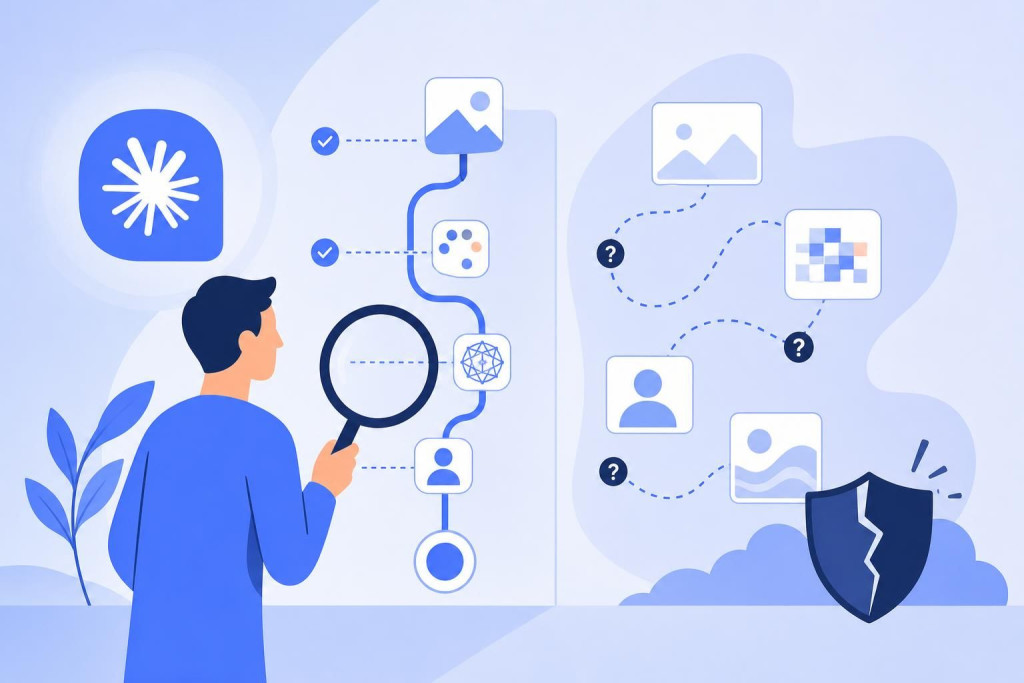
Depuis le 2 août 2026, le filigrane automatique des textes et images générés par Claude s’inscrit dans un cadre plus large : celui de l’obligation européenne de transparence sur certains contenus produits par intelligence artificielle. Anthropic a franchi une étape supplémentaire le 2 septembre en publiant un détecteur gratuit de fichiers attribués à Claude. L’outil, fondé sur les métadonnées de provenance, promet de vérifier l’origine d’images, de vidéos et de fichiers audio. Mais ses premiers essais soulignent une limite centrale : la traçabilité technique ne constitue pas encore une preuve absolue.
Une réponse technique à l’exigence de transparence sur les contenus IA

Le calendrier européen accélère la mise en conformité
Le règlement européen sur l’intelligence artificielle, officiellement le règlement (UE) 2024/1689, organise une entrée en vigueur progressive de ses obligations. Depuis le 2 août 2026, son article 50 impose des règles de transparence aux fournisseurs et aux déployeurs de certains systèmes d’IA générative.
Le texte distingue plusieurs cas. Les systèmes produisant ou manipulant des contenus synthétiques doivent, sous certaines conditions, permettre d’identifier ces contenus comme générés ou altérés par une IA. Les contenus audiovisuels présentant des personnes, objets, lieux ou événements fictifs — souvent désignés sous le terme de deepfakes — sont particulièrement concernés. Les interactions avec un agent conversationnel doivent également être transparentes lorsque leur nature artificielle n’est pas évidente.
Les contenus éditoriaux ne relèvent toutefois pas mécaniquement d’une obligation générale d’étiquetage visible. Le règlement prévoit notamment une exception pour les textes publiés afin d’informer le public sur des sujets d’intérêt général lorsqu’ils ont fait l’objet d’un contrôle humain et qu’une personne physique ou morale assume la responsabilité éditoriale de leur publication.
Le cadre juridique reste donc plus nuancé que l’idée d’une mention « généré par IA » apposée sur chaque production.
Anthropic associe marquage textuel et provenance des fichiers
Dans les informations communiquées en août 2026, Anthropic indique avoir intégré un mécanisme de filigrane invisible dans les nouveaux modèles Claude. Selon les présentations relayées par les sources, ce marquage est appliqué au niveau du modèle et vise à subsister lors de certains copier-coller ou retouches du texte.
Pour les fichiers multimédias, l’entreprise s’appuie sur une logique différente : les « content credentials », c’est-à-dire des informations de provenance attachées au fichier et signées cryptographiquement. Ce dispositif repose sur le standard ouvert C2PA, pour Coalition for Content Provenance and Authenticity, soutenu notamment par Adobe, Microsoft, Intel, la BBC et plusieurs fabricants d’appareils photo.

Ces deux approches ne remplissent pas la même fonction. Le filigrane textuel cherche à identifier une génération issue d’un modèle ; les métadonnées C2PA documentent une chaîne de provenance liée à un fichier.
Le détecteur de fichiers Claude : ce que vérifie réellement l’outil

Une lecture locale des métadonnées
Le 2 septembre, Anthropic a mis en ligne un service public intitulé « Check if a file was made with Claude ». L’outil accepte des fichiers image, audio et vidéo dans une limite de 100 Mo. Il ne vise pas, à ce stade, les documents bureautiques ni les textes collés dans une interface de publication.
Selon Anthropic, l’analyse est effectuée directement dans le navigateur. Les fichiers ne seraient donc pas transférés sur les serveurs de l’entreprise. Le mécanisme examine les métadonnées C2PA présentes dans le fichier, notamment les informations cryptographiques destinées à attester de l’origine ou de la transformation du contenu.
- Formats visés : images, fichiers audio et vidéos ;
- Limite annoncée : 100 Mo par fichier ;
- Mode de traitement revendiqué : analyse locale dans le navigateur ;
- Base technique : métadonnées et signatures du standard C2PA ;
- Résultat attendu : indication sur le passage éventuel du fichier par Claude.
Une vérification de provenance, non un détecteur universel d’IA
La distinction est déterminante pour les équipes marketing et éditoriales. L’outil ne semble pas déterminer avec certitude qu’un visuel a été créé par une IA, ni attribuer un contenu à l’ensemble du marché des modèles génératifs. Il recherche surtout une trace de provenance compatible avec les mécanismes déployés par Anthropic.
Un résultat négatif ne permet donc pas d’affirmer qu’un fichier a été produit par un humain. Il peut indiquer que le document ne contient pas les métadonnées recherchées, que celles-ci ont été retirées lors d’une exportation, ou qu’il provient d’un autre outil de génération.
Inversement, un résultat positif documente une information technique sur le parcours d’un fichier, sans résoudre à lui seul la question de sa responsabilité éditoriale, de son exactitude ou de son droit d’utilisation.
| Date / Indicateur | Événement / Valeur |
|---|---|
| 2 août 2026 | Application des obligations de transparence prévues à l’article 50 du règlement européen sur l’IA. |
| Mi-août 2026 | Communication d’Anthropic sur un filigrane textuel et des credentials de provenance pour certains fichiers Claude. |
| 2 septembre 2026 | Mise en ligne du vérificateur public de fichiers attribués à Claude. |
| 100 Mo | Taille maximale annoncée pour un fichier analysé par le vérificateur. |
| Formats couverts | Image, vidéo et audio ; les textes ne sont pas inclus dans le périmètre présenté. |
La fiabilité contestée des marqueurs de provenance

Des résultats contradictoires lors des premiers tests
La principale réserve apportée par les sources concerne la robustesse opérationnelle du détecteur. Un test croisé réalisé par la rédaction de BDM sur un même fichier aurait produit des résultats différents selon les machines utilisées. L’outil a ainsi identifié, dans certains cas, un traitement lié à Claude, sans parvenir à le faire de manière constante.
Ce type d’écart appelle à la prudence. Les signatures de provenance dépendent de plusieurs paramètres : intégrité des métadonnées, compatibilité du navigateur, modalités d’exportation, compression appliquée par les plateformes et conservation des données lors de la circulation du fichier.
« Un mécanisme de provenance ne vaut que tant que l’information de provenance est préservée dans le cycle de diffusion du fichier. »
Cette limite est connue dans l’ensemble du secteur. De nombreux services de messagerie, réseaux sociaux, éditeurs d’images ou outils de conversion peuvent supprimer, modifier ou réécrire les métadonnées lors d’une publication.
La suppression des métadonnées demeure un point faible
Les métadonnées constituent un moyen utile d’établir un contexte de création, mais elles restent vulnérables. Une capture d’écran, une conversion de format, un recadrage ou une exportation mal paramétrée peuvent suffire à faire disparaître une partie des informations de provenance. À l’inverse, la présence d’une métadonnée ne signifie pas nécessairement que le fichier final n’a pas été largement transformé par un opérateur humain.
Le développement de signatures cryptographiques améliore la résistance à la falsification par rapport aux simples champs EXIF traditionnels. Il ne supprime pas la possibilité de rompre la chaîne de traçabilité. Il établit surtout une différence entre un fichier dont la provenance peut être documentée et un fichier dont elle ne peut pas l’être.
L’article 50 du règlement européen : obligations et exceptions
Une obligation qui pèse différemment selon le rôle de l’entreprise
L’article 50 du règlement européen ne vise pas indistinctement toutes les entreprises utilisant un outil d’IA. Il répartit les responsabilités entre les fournisseurs de modèles ou de systèmes, les entreprises qui déploient ces systèmes et les acteurs qui diffusent des contenus synthétiques auprès du public.
Les fournisseurs doivent concevoir leurs solutions de sorte que les sorties puissent être détectées ou identifiées sous une forme lisible par machine lorsque cela est techniquement possible et proportionné. Les déployeurs qui rendent publics certains contenus artificiels ou manipulés doivent, eux, respecter des exigences d’information adaptées au contexte.
Le texte complet peut être consulté sur le site EUR-Lex, la base officielle du droit de l’Union européenne.
Les contenus éditoriaux sous supervision humaine bénéficient d’un régime spécifique
Pour les éditeurs, les marques et les entreprises qui publient des articles, l’enjeu réside dans la nature réelle de l’intervention humaine. Une assistance limitée à la correction, à la reformulation, à la mise en page ou à la préparation d’un plan n’équivaut pas automatiquement à une génération substantielle de contenu.
Dans le cas d’un article d’information produit avec une IA mais vérifié, enrichi et assumé par une rédaction identifiée, l’exception prévue par le règlement peut s’appliquer. Cela ne dispense pas de respecter les autres règles : droit de la consommation, droit d’auteur, loyauté des pratiques commerciales, protection des données et obligations sectorielles éventuelles.
La transparence ne se réduit donc pas à une étiquette. Elle repose aussi sur la traçabilité interne des processus et sur l’existence d’un responsable éditorial clairement désigné.
Les conséquences pour les stratégies de contenu et le référencement naturel
Google évalue la valeur du contenu, non son seul mode de production
Pour le référencement naturel, l’arrivée de filigranes et de détecteurs ne modifie pas le principe régulièrement rappelé par Google : le moteur cherche à évaluer l’utilité, la fiabilité et l’originalité des contenus plutôt que leur origine purement humaine ou automatisée. La production massive de pages sans valeur ajoutée, qu’elle soit réalisée par IA ou non, demeure susceptible d’être considérée comme du spam.
Les critères liés à l’expérience, l’expertise, l’autorité et la fiabilité — souvent résumés par l’acronyme E-E-A-T — conservent leur rôle dans la production éditoriale. Une trace C2PA ne remplace ni la vérification des faits, ni une source primaire, ni la cohérence avec l’intention de recherche.
Les consignes de Google sur les contenus générés par IA et le spam sont accessibles dans sa documentation destinée aux créateurs de contenus.
Automatiser sans effacer la responsabilité humaine
Les entreprises disposent désormais d’outils capables d’automatiser une part importante de la chaîne éditoriale : détection de sujets dans des flux RSS, construction de cocons sémantiques, préparation de briefs, rédaction de premières versions, mise à jour des contenus anciens et publication dans WordPress.
Cette industrialisation améliore la régularité et réduit le temps consacré aux opérations répétitives. Elle accroît simultanément le besoin de contrôle. Un contenu automatisé qui contient une donnée obsolète, une citation inexistante ou une affirmation juridique imprécise peut être publié à grande échelle si aucun circuit de relecture n’est établi.
- Conserver les sources utilisées lors de la préparation d’un article ;
- Faire valider les contenus sensibles par un expert métier ou juridique ;
- Documenter les outils d’IA employés dans le processus de production ;
- Prévoir une politique de correction, de mise à jour et de retrait ;
- Mesurer la performance SEO et commerciale après publication, au-delà du volume produit.
Vers une chaîne éditoriale plus documentée
Le marquage pourrait devenir une norme de marché
Anthropic n’est pas seul à investir le terrain de la provenance. Adobe a largement contribué au développement des Content Credentials, tandis que plusieurs entreprises technologiques expérimentent des marqueurs visibles, invisibles ou cryptographiques pour attester de l’origine des contenus. L’enjeu dépasse la détection de l’IA : il concerne également la lutte contre la désinformation, l’usurpation d’identité et la manipulation de documents visuels.
La multiplication de standards concurrents pourrait toutefois compliquer l’adoption. Une entreprise qui produit des contenus via plusieurs modèles devra être capable de comprendre les différences entre les marquages, leurs limites de conservation et les outils qui permettent de les consulter.
La preuve technique ne remplace pas la gouvernance éditoriale
Pour les directions marketing, le sujet devient moins celui de la seule capacité à générer du contenu que celui de la maîtrise de son cycle de vie. Qui a validé le brief ? Quelles sources ont alimenté l’article ? Quel modèle a été utilisé ? Une personne qualifiée a-t-elle vérifié les informations avant publication ? Les réponses à ces questions constituent une protection plus solide qu’un simple signal automatisé.
Dans cette perspective, les plateformes d’automatisation éditoriale ont intérêt à intégrer des étapes de validation, des historiques de modifications et des mécanismes de suivi des performances. La promesse de gain de temps ne peut durablement se dissocier d’une exigence de preuve et de contrôle.
Une transparence utile, mais encore incomplète
Le risque d’un faux sentiment de certitude
Le vérificateur d’Anthropic apporte un outil concret au débat sur l’identification des contenus générés. Son accès gratuit et son fonctionnement local répondent à des attentes de simplicité et de confidentialité. Ses résultats contradictoires signalés lors des premiers tests montrent néanmoins qu’il ne doit pas être utilisé comme un arbitre unique.
Pour un éditeur, une agence ou une entreprise, un détecteur de provenance peut servir d’indice dans une procédure de contrôle. Il ne peut pas, à lui seul, établir l’authenticité d’une information, attribuer avec certitude un contenu à son auteur ou qualifier la conformité juridique d’une publication.
Le prochain enjeu : rendre la provenance interopérable
La portée réelle de ces dispositifs dépendra de leur adoption par les logiciels de création, les CMS, les plateformes sociales et les navigateurs. Tant que les métadonnées pourront disparaître au premier export ou lors d’une publication sur un réseau social, la promesse de traçabilité restera partielle.
Le déploiement de ces outils ouvre ainsi un nouveau chantier pour la production de contenu : non plus seulement produire vite et publier souvent, mais conserver, tout au long de la chaîne éditoriale, les éléments permettant d’en établir l’origine, les transformations et la responsabilité.